
Meta deve nominare dirigenti nella causa legale sull'IA
Un tribunale statunitense costringe Meta a nominare i responsabili della pirateria dell'IA. L'azienda è sotto pressione a causa dell'addestramento dei suoi modelli di IA.
Meta, la società madre di Facebook e Instagram, si trova sotto una notevole pressione legale dopo che un tribunale federale degli Stati Uniti ha deciso che l'azienda deve nominare tutti i dirigenti responsabili dell'approvazione dei download da quelle che vengono chiamate biblioteche ombra. Queste biblioteche ombra sono archivi digitali che forniscono contenuti protetti da copyright senza il consenso dei titolari dei diritti.
La causa legale riguarda le pratiche di Meta nell'addestramento dei suoi modelli di intelligenza artificiale, che si basano su grandi quantità di dati. I critici accusano l'azienda di aver ottenuto questi dati da fonti non autorizzate, il che potrebbe portare a una violazione dei diritti d'autore. Il tribunale ha ora deciso che la divulgazione dei nomi dei dirigenti responsabili è necessaria per chiarire le accuse.
Causa legale e le sue implicazioni
La decisione del tribunale potrebbe avere conseguenze di vasta portata per Meta e per l'intero settore tecnologico. Se si dovesse scoprire che Meta ha violato consapevolmente le leggi sul copyright, ciò potrebbe non solo portare a pesanti multe, ma anche compromettere la fiducia degli utenti nelle piattaforme dell'azienda. La divulgazione dei nomi potrebbe inoltre portare a ulteriori azioni legali contro i dirigenti coinvolti.
Meta ha sottolineato in passato che l'uso dei dati per l'addestramento dei modelli di intelligenza artificiale è fondamentale per lo sviluppo delle proprie tecnologie. Tuttavia, l'azienda è sotto pressione per essere trasparente e rispettare le normative legali. La situazione attuale potrebbe anche spingere altre aziende a rivedere le proprie pratiche nella gestione dei dati.
Le biblioteche ombra, da cui Meta potrebbe aver ottenuto dati, sono un tema controverso nel mondo digitale. Offrono accesso a una vasta gamma di contenuti, spesso protetti da copyright, e rappresentano quindi una sfida per i titolari dei diritti. L'uso di tali fonti potrebbe essere considerato una forma di pirateria, aumentando i rischi legali per aziende come Meta.
La decisione del tribunale è parte di una tendenza più ampia, in cui le autorità di regolamentazione e i tribunali stanno sempre più agendo contro le aziende che violano i diritti d'autore nel mondo digitale. Questi sviluppi potrebbero portare le aziende a essere più caute nell'uso dei dati in futuro, specialmente per quanto riguarda l'addestramento dell'IA.
Meta non ha ancora rilasciato una dichiarazione ufficiale sulla sentenza. Resta da vedere come l'azienda risponderà alla richiesta di divulgare i nomi dei dirigenti responsabili. I prossimi passi nella causa legale potrebbero essere decisivi per l'evoluzione delle normative sull'uso dei dati nello sviluppo dell'IA.
La sentenza potrebbe avere anche un impatto sulla percezione pubblica delle tecnologie di intelligenza artificiale. Consumatori e utenti potrebbero reagire in modo più sensibile all'origine dei dati utilizzati per lo sviluppo dei modelli di IA. Questo potrebbe portare a un maggiore interesse per la trasparenza e gli standard etici nello sviluppo dell'IA.
Ähnliche Artikel
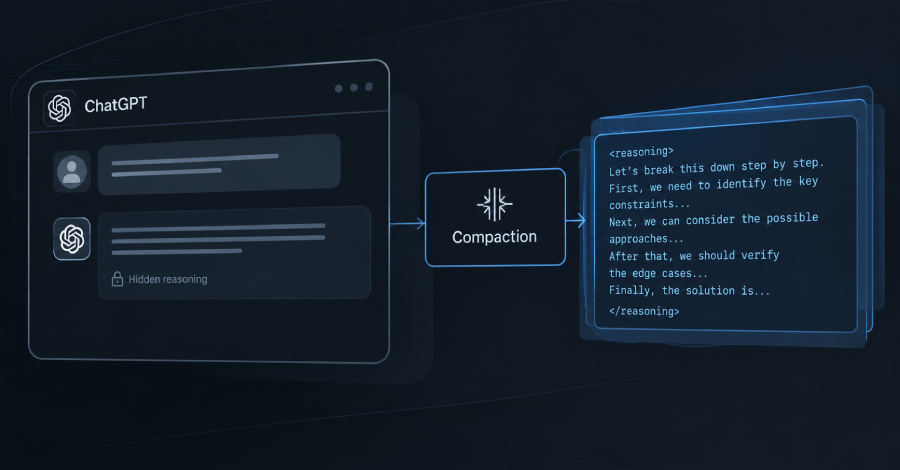
La funzione di Compattazione di OpenAI mette a rischio la sicurezza
Un nuovo rapporto sulla sicurezza mostra che la funzione di Compattazione di OpenAI può essere utilizzata per estrarre p...
Gli eredi di Elvis citano in giudizio l'azienda di IA Anthropic
I titolari dei diritti di Elvis Presley hanno citato in giudizio Anthropic, poiché l'IA Claude è stata addestrata con 27...
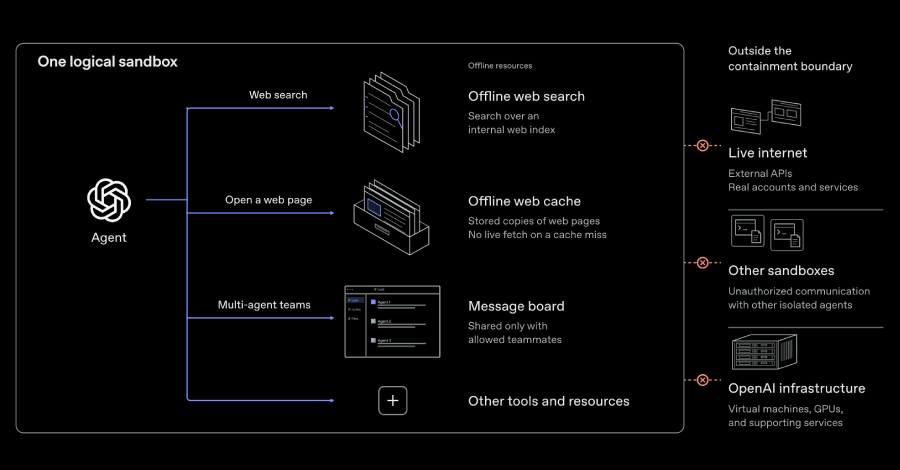
OpenAI annuncia nuove misure di sicurezza
OpenAI prevede di addestrare i suoi modelli di intelligenza artificiale più avanzati senza accesso a Internet....
La Cina reagisce alle perdite di lavoro legate all'IA
Il Consiglio di Stato cinese ha introdotto misure per contenere le perdite di lavoro causate dall'IA. Le aziende devono ...

comment Kommentare (0)
Noch keine Kommentare. Schreiben Sie den ersten!
Kommentar hinterlassen